자율주행용 멀티센서 데이터셋 nuScenes 의 센서 구성, 좌표계, 데이터 구조, 3D Detection 평가 지표(mAP, NDS) 정리 및 BEVFormer 에 입력되는 데이터 구성
nuScenes
Motional(구 nuTonomy)이 공개한 360° 전방위 멀티센서 자율주행 데이터셋 . (CVPR 2020)
카메라 6대, LiDAR 1대, Radar 5대, GPS/IMU를 모두 포함하는 최초의 대규모 데이터셋으로, 카메라 기반 3D 검출(BEVFormer, BEVDet, DETR3D 등)의 표준 벤치마크로 사용된다.
Website : nuScenes Devkit : GitHub - nutonomy/nuscenes-devkit License : CC BY-NC-SA 4.0 (비상업 용도)
한 keyframe에서 동시에 촬영된 카메라 6장 (mini scene-0553, Boston Seaport 교차로)
위 줄은 전방 3대, 아래 줄은 후방 3대이며, 이웃 카메라끼리 시야가 일부 겹친다.
데이터 규모
항목 내용 수집 지역 Boston (Seaport), Singapore (One-North, Queenstown, Holland Village) Scene 1,000개 × 20초 (train 700 / val 150 / test 150)Keyframe (sample) 약 40k개, 2Hz 로 annotation 센서 데이터 카메라 이미지 약 1.4M장, LiDAR sweep 약 390k개, Radar sweep 약 1.4M개 3D Box 약 1.4M개, 23개 클래스 + 8개 속성(attribute) 주행 조건 주간 / 야간 / 비, 좌측 통행(Singapore)과 우측 통행(Boston)
버전 Scene 수 용도 v1.0-mini10 (train 8 / val 2) 코드 테스트용 (약 4GB) v1.0-trainval850 (train 700 / val 150) 학습 및 검증 v1.0-test150 리더보드 제출용 (GT 미공개)
mini의 val scene은 scene-0103, scene-0916 2개로 구성된다.
센서 구성
데이터 수집 차량은 Renault Zoe 2대이며, 두 차량의 센서 배치는 같다.
센서 수량 주기 사양 Camera 6 12Hz 1600×900 (ROI crop), 전방위 360° 커버, 후방 카메라만 광각 LiDAR 1 20Hz Velodyne HDL-32E, 32채널 , 수평 360° / 수직 +10° ~ −30°, sweep당 약 34k points Radar 5 13Hz Continental ARS 408-21, 77GHz, 최대 250m, 도플러 속도 측정 GPS / IMU 1 - 위치 + LiDAR 맵 매칭 기반 localization
센서 배치 (Ego 좌표계, Top View)
mini scene-0061의 실제 캘리브레이션 값으로 그린 배치도이다. (차체 외곽은 Renault Zoe 크기로 근사)
각도는 ego +x 기준 광축(Radar는 정면) 방향이며, 반시계 방향이 +이다.
부채꼴은 카메라별 수평 FOV이며, 실제 시야는 이보다 훨씬 멀리까지 이어진다.
카메라 캘리브레이션 (mini scene-0061의 calibrated_sensor 기준)
채널 광축 방향 위치 (x, y, z) [m] f x 수평 FOV* CAM_FRONT 0° (1.70, 0.02, 1.51) 1266 64.6° CAM_FRONT_RIGHT −56° (1.55, −0.49, 1.50) 1261 64.8° CAM_FRONT_LEFT +55° (1.52, 0.50, 1.51) 1273 64.3° CAM_BACK 180° (0.03, 0.00, 1.58) 809 89.3° CAM_BACK_LEFT +109° (1.04, 0.49, 1.59) 1257 65.0° CAM_BACK_RIGHT −111° (1.02, −0.48, 1.56) 1260 64.8°
위치와 f x calibrated_sensor의 translation, camera_intrinsic 값이고, 광축 방향은 rotation quaternion으로 카메라 z축을 ego 좌표로 변환해 계산한 값이다.
* 제공된 내부 파라미터로 계산한 값: FOV = 2 arctan ( 800/ f x ) 65° (후방 약 8990°)로 거의 같다.
인접 카메라 사이 각도가 약 55°이고 FOV가 약 65°이므로, 이웃 카메라끼리 약 10° 정도 겹친다 .
캘리브레이션은 scene(log)마다 따로 제공 된다. (calibrated_sensor 120개 = mini 10 scene × 센서 12개)
센서별 데이터 형식
센서 파일 내용 Camera .jpg1600×900 RGB (원본 1600×1200에서 세로 crop), 왜곡 계수 없이 내부 파라미터 K LiDAR .pcd.binfloat32 × 5: x, y, z, intensity, ring index(0~31) (LiDAR 좌표계) Radar .pcdx, y, z, vx, vy, vx_comp, vy_comp, rcs, dyn_prop, ... 18개 필드, 프레임당 수십~백여 개 points
센서 동기화
카메라는 LiDAR가 회전하면서 해당 카메라 FOV 중앙을 지날 때 촬영 되도록 트리거된다.
따라서 한 sample 안에서도 카메라 6장의 촬영 시각이 서로 다르다.
sample의 timestamp는 LIDAR_TOP keyframe 시각이다.
예: CAM_FRONT는 LiDAR보다 약 35ms 앞선다.
그래서 카메라 → LiDAR 변환은 각 센서 시각의 ego pose를 따로 사용 해야 정확하다. (아래 좌표 변환 참고)
좌표계
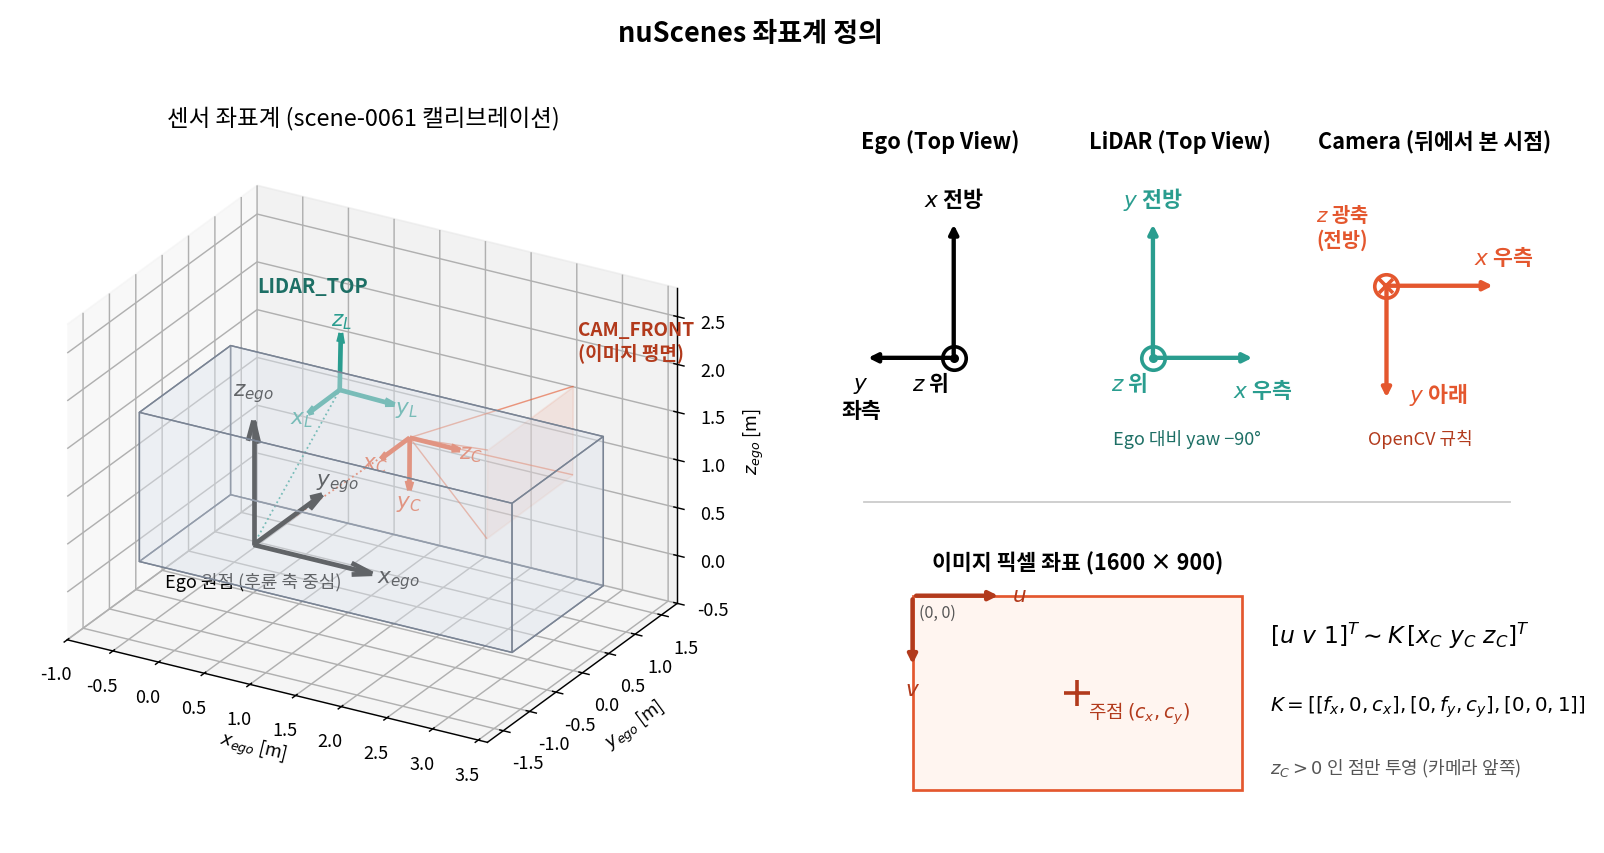
좌표계 정의
좌표계 원점 축 방향 비고 Global (Map) 지역별 지도 원점 x, y: 지도 평면, z: 위 annotation과 결과 json의 기준 Ego 후륜 축 중심 x: 전방, y: 좌측, z: 위 ego_pose는 2D localization이라 translation의 z는 항상 0LiDAR (LIDAR_TOP)차량 지붕, ego 원점 기준 (0.94, 0, 1.84)m x: 우측, y: 전방, z: 위 ego 대비 yaw −90°. BEVFormer 출력 박스의 기준 Camera 각 카메라 광학 중심 x: 우측, y: 아래, z: 광축(전방) OpenCV 규칙 Radar 각 Radar x: 전방, y: 좌측, z: 위 ego와 같은 규칙
왼쪽: mini scene-0061 캘리브레이션으로 그린 Ego(검정), LiDAR(초록), CAM_FRONT(주황) 좌표계와 CAM_FRONT 이미지 평면
오른쪽: 좌표계별 축 방향 규칙과 이미지 픽셀 좌표 (원점은 좌상단, u v
변환 관계
nuScenes는 변환을 센서 → Ego (calibrated_sensor)와 Ego → Global (ego_pose) 두 단계로만 제공한다.
각 변환은 translation (x, y, z)와 rotation (quaternion, w, x, y, z 순서)으로 표현된다.
센서끼리의 변환(LiDAR → Camera 등)은 이 두 단계를 조합해서 만든다.
Sensor ──(calibrated_sensor)──▶ Ego(t) ──(ego_pose at t)──▶ Global
좌표 변환
LiDAR 좌표의 점 p L
t L t C
p ~ im g = K ⋅ T e g o ( t C ) c am ⋅ T g l o ba l e g o ( t C ) ⋅ T e g o ( t L ) g l o ba l ⋅ T l i d a r e g o ( t L ) ⋅ p ~ L ( u , v ) = ( p ~ z p ~ x , p ~ z p ~ y ) , p ~ z > 0 ( 카메라 앞쪽 )
가운데 두 항(T g l o ba l e g o ( t C ) ⋅ T e g o ( t L ) g l o ba l 두 시각 사이 자차 이동을 보상 하는 부분이다.
BEVFormer의 create_data.py는 이 체인을 미리 계산해 sensor2lidar_rotation/translation으로 저장하고, 데이터셋에서 K lidar2img를 만든다.
3D Box 표현
3D Box는 중심 위치, 크기, 방향 (+ 속도)으로 표현한다.
같은 Box라도 어디에 저장되고 어디서 쓰이는지 에 따라 기준 좌표계와 표기 방식이 달라진다.
구분 출처 좌표계 중심 기준 크기 방향 속도 원본 annotation sample_annotation.jsonGlobal 기하 중심 w, l, h quaternion 없음 devkit Box 객체 nusc.get_sample_data()지정한 센서 기하 중심 w, l, h quaternion 없음 결과 제출 파일 results_nusc.jsonGlobal 기하 중심 w, l, h quaternion vx, vy BEVFormer info pkl gt_boxes, gt_velocityLiDAR 기하 중심 w, l, h yaw’ vx, vy BEVFormer 학습 GT LiDARInstance3DBoxesLiDAR 바닥 중심 w, l, h yaw’ vx, vy
구분 : Box가 저장되거나 사용되는 곳. 위 3개는 nuScenes 공통이고, 아래 2개는 BEVFormer(mmdet3d 0.x)가 변환한 형태이다.중심 기준 : 기하 중심은 박스의 정중앙, 바닥 중심은 박스 아랫면의 중앙 (기하 중심 z − h/2)이다.크기 : w = 폭(좌우), l = 길이(전후), h = 높이 [m]. 순서가 **(w, l, h)**인 점에 주의한다. (KITTI는 h, w, l)방향 : quaternion은 (w, x, y, z) 순서이며, 지면 위 박스이므로 사실상 z축 회전(yaw)만 갖는다.
yaw’은 mmdet3d 0.x LiDAR 박스 규칙으로 바꾼 값이다: y a w ′ = − y a w − π /2
속도 : 원본 annotation에는 저장되지 않는다. 같은 instance의 이전·다음 annotation 위치 차이로 계산한다. (nusc.box_velocity())
// 원본 annotation 예시 (mini, 보행자) { "translation" : [ 373.214 , 1130.48 , 1.25 ], // Global 좌표의 기하 중심 [m] "size" : [ 0.621 , 0.669 , 1.642 ], // w, l, h [m] "rotation" : [ 0.9831 , 0.0 , 0.0 , -0.1830 ] // quaternion (w, x, y, z) } 데이터 구조
폴더 구조
본 데이터와 확장 데이터(Map, CAN bus)를 모두 하나의 루트 폴더에 풀었을 때의 구조이다. 이 루트 폴더가 devkit의 dataroot가 된다.
nuscenes/                                    # 데이터셋 루트 (devkit dataroot)
├── maps/
│   ├── *.png                                # 지역별 래스터 지도 4장 (파일명 = map token)
│   ├── basemap/                             # [Map expansion] 지역별 배경 지도 이미지
│   ├── expansion/                           # [Map expansion] 지역별 벡터 지도 json 4개
│   └── prediction/                          # [Map expansion] Prediction task용 scene 목록
├── samples/                                 # keyframe(2Hz) 센서 데이터 → annotation 있음
│   ├── CAM_FRONT/ ... CAM_BACK_RIGHT/       # 카메라 6개, *.jpg
│   ├── LIDAR_TOP/                           # LiDAR, *.pcd.bin
│   └── RADAR_FRONT/ ... RADAR_BACK_RIGHT/   # Radar 5개, *.pcd
├── sweeps/                                  # keyframe 사이의 중간 프레임 → annotation 없음
│   └── (samples와 같은 12개 채널)
├── can_bus/                                 # [CAN bus expansion] scene별 차량 신호 (scene마다 8개 파일)
│   ├── scene-0001_meta.json                 # 메시지별 개수, 주기, 값 통계
│   ├── scene-0001_route.json                # 기준 주행 경로 (Global x, y 좌표 목록)
│   ├── scene-0001_pose.json                 # 50Hz  위치, 자세, 속도, 가속도, 각속도
│   ├── scene-0001_ms_imu.json               # 100Hz IMU (가속도, 자세 quaternion, 각속도)
│   ├── scene-0001_steeranglefeedback.json   # 100Hz 조향각
│   ├── scene-0001_zoe_veh_info.json         # 100Hz 휠 속도, 종·횡 가속도, odometry
│   ├── scene-0001_zoesensors.json           # 약 1kHz 브레이크, 조향, 스로틀 센서
│   ├── scene-0001_vehicle_monitor.json      # 2Hz  차속, yaw rate, 기어, 방향지시등
│   └── ...
└── v1.0-mini/                               # 메타데이터 (JSON 테이블 13개)
    ├── log.json                 # 주행 기록 정보 (차량, 날짜, 지역)
    ├── scene.json               # 20초 주행 구간 정보 (이름, 설명, 첫/끝 sample)
    ├── sample.json              # 2Hz keyframe 목록 (시각, scene, 앞뒤 keyframe)
    ├── sample_data.json         # 센서 데이터 파일 목록 (경로, 시각, keyframe 여부, 앞뒤 프레임)
    ├── ego_pose.json            # 각 sample_data 시각의 Ego → Global 변환
    ├── calibrated_sensor.json   # 센서 → Ego 외부 파라미터 + 카메라 내부 파라미터 K
    ├── sensor.json              # 센서 채널 12개 (이름, 종류)
    ├── sample_annotation.json   # 3D box (위치, 크기, 회전, 속성, point 개수, 가시성)
    ├── instance.json            # 객체 단위 track (클래스, annotation 개수, 첫/끝 annotation)
    ├── category.json            # 객체 클래스 23개
    ├── attribute.json           # 객체 상태 8개 (moving, parked 등)
    ├── visibility.json          # 가시성 등급 4개 (0~40%, ..., 80~100%)
    └── map.json                 # 지도 파일과 해당 log 연결
폴더 제공 역할 용량 maps/본 데이터 + Map expansion 본 데이터에는 지역별 래스터 지도 4장만 있으며, map.json이 지도 파일과 log를 연결한다. Map expansion을 받으면 차선, 횡단보도, 주행 가능 영역 같은 벡터 지도 (expansion/)와 배경 지도(basemap/), Prediction용 scene 목록(prediction/)이 추가된다. 5.6MB (래스터 지도) samples/본 데이터 2Hz keyframe 센서 데이터. annotation이 달린 프레임이며, 학습과 평가에 쓰는 기본 데이터이다. 채널별 폴더 12개로 나뉜다.706MB (mini) sweeps/본 데이터 keyframe 사이의 중간 프레임 (카메라 12Hz, LiDAR 20Hz, Radar 13Hz 중 keyframe을 제외한 나머지). annotation은 없으며, LiDAR 다중 sweep 누적이나 시간 정보 활용에 쓴다. 4.4GB (mini) can_bus/CAN bus expansion 차량 내부 신호(CAN bus)를 scene 단위 json 8개 로 제공한다. 메시지마다 utime(μs) timestamp가 있어 sample timestamp와 맞춰 쓸 수 있다. 버전 폴더와 관계없이 전체 scene을 한 번에 제공하며, 일부 scene은 데이터가 없다 (979개 scene 제공). 780MB (zip), 4.4GB (압축 해제) v1.0-*/본 데이터 모든 센서 데이터, 캘리브레이션, pose, annotation을 token으로 연결하는 메타데이터 테이블 . 버전 이름(v1.0-mini, v1.0-trainval, v1.0-test)이 폴더 이름이 된다. 32MB (mini)
lidarseg, panoptic 확장을 받으면 루트에 lidarseg/, panoptic/ 폴더(point별 label 파일)가 생기고, v1.0-*/에 해당 메타데이터 json이 추가된다.
CAN bus 메시지별 주기와 필드는 아래 확장 데이터 (Expansion) 를 참고한다.
파일 이름: {log}__{채널}__{timestamp(μs)}.{ext}
예: n015-2018-07-24-11-22-45+0800__CAM_FRONT__1532402927612460.jpg
메타데이터에서 용량이 큰 파일은 sample_data.json(15MB), sample_annotation.json(9MB), ego_pose.json(7MB)이다. 센서 프레임마다 레코드가 1개씩 있기 때문이다.
각 테이블의 필드와 관계는 아래 테이블 설명 을 참고한다.
테이블 관계 (Relational Schema)
모든 레코드는 고유한 token(32자리 hex)을 가지며, 다른 테이블을 token으로 참조 하는 관계형 구조이다.
 log ──< scene ──< sample ──< sample_data >── calibrated_sensor >── sensor
  │                  │            │
 map                 │            └──── ego_pose  (sample_data와 1:1)
                     │
                     └──< sample_annotation >── instance >── category
                              │    │
                              │    └── attribute (N:M)
                              └── visibility
 (──< : 1:N,  >── : N:1)
테이블 설명
테이블(JSON) 의미 주요 필드 개수(mini) log주행 기록 1회 vehicle, date_captured, location8 scene20초 길이의 주행 구간 name, description, nbr_samples, first/last_sample_token10 sample2Hz keyframe (annotation 단위)timestamp, prev, next, scene_token404 sample_data센서 1개의 데이터 1개 (keyframe + sweep) filename, is_key_frame, timestamp, ego_pose_token, calibrated_sensor_token31,206 ego_pose해당 시각의 Ego → Global 변환 translation, rotation31,206 calibrated_sensor센서 → Ego 외부 파라미터 + 내부 파라미터 translation, rotation, camera_intrinsic (3×3, 카메라만)120 sensor센서 종류 channel (예: CAM_FRONT), modality12 sample_annotation3D box 1개 translation, size, rotation, num_lidar_pts, num_radar_pts, prev, next18,538 instance객체 1개 (여러 프레임에 걸친 track) category_token, nbr_annotations911 category객체 클래스 (23개) name (예: vehicle.car)23 attribute객체 상태 (8개) name (예: vehicle.parked)8 visibility6개 카메라 기준 보이는 비율 level (v0-40, v40-60, v60-80, v80-100)4 map지도 이미지 filename, log_tokens4
sample_data의 prev / next는 같은 센서의 바로 앞뒤 프레임 (sweep 포함)을, sample의 prev / next는 앞뒤 keyframe 을 가리킨다.sample.json 파일에는 data, anns 필드가 없지만, devkit이 로딩 시 역참조 인덱스를 만들어 sample['data'][채널], sample['anns']로 접근할 수 있게 해준다.mini에서 keyframe은 센서마다 404개(= sample 수)이고, 나머지는 sweep이다. (예: LIDAR_TOP 3,935개 중 404개가 keyframe)
카테고리와 속성
원본 23개 클래스 를 Detection 벤치마크에서는 10개 클래스 로 묶어서 평가한다.
Detection 클래스 원본 카테고리 car vehicle.cartruck vehicle.truckbus vehicle.bus.bendy, vehicle.bus.rigidtrailer vehicle.trailerconstruction_vehicle vehicle.constructionpedestrian human.pedestrian.adult / child / construction_worker / police_officermotorcycle vehicle.motorcyclebicycle vehicle.bicycletraffic_cone movable_object.trafficconebarrier movable_object.barrier(평가 제외) animal, human.pedestrian.stroller / wheelchair / personal_mobility, vehicle.emergency.*, movable_object.pushable_pullable / debris, static_object.bicycle_rack
속성 (attribute) 대상 vehicle.moving / stopped / parked차량류 cycle.with_rider / without_rider자전거, 오토바이 pedestrian.moving / standing / sitting_lying_down보행자
devkit 사용 예
nuscenes-devkit 은 nuScenes 공식 Python 라이브러리로, JSON 메타데이터 테이블을 불러와 token으로 서로 연결해 주고, 센서 데이터 로드, 좌표 변환, 시각화, 공식 평가 코드를 함께 제공한다.pip install nuscenes-devkitnuscenes.nuscenes: 데이터셋 로딩과 테이블 조회 (NuScenes 클래스)nuscenes.utils: Box, LidarPointCloud 등 데이터 클래스와 좌표 변환·투영 함수nuscenes.eval: Detection, Tracking, Prediction, LiDAR segmentation 공식 평가 코드nuscenes.map_expansion, nuscenes.can_bus, nuscenes.lidarseg, nuscenes.panoptic: 확장 데이터용 APInuscenes.scripts: 2D box 추출, KITTI 형식 변환 등 유틸리티 스크립트
from nuscenes.nuscenes import NuScenes nusc = NuScenes( version = 'v1.0-mini' , dataroot = './data/nuscenes' , verbose = True )
scene = nusc.scene[ 0 ] sample = nusc.get( 'sample' , scene[ 'first_sample_token' ]) # 첫 keyframe cam_sd = nusc.get( 'sample_data' , sample[ 'data' ][ 'CAM_FRONT' ]) # 카메라 데이터 calib = nusc.get( 'calibrated_sensor' , cam_sd[ 'calibrated_sensor_token' ]) # 카메라 → ego pose = nusc.get( 'ego_pose' , cam_sd[ 'ego_pose_token' ]) # ego → global
# 이미지 경로, 카메라 좌표계로 변환된 GT box, 내부 파라미터 path, boxes, K = nusc.get_sample_data(sample[ 'data' ][ 'CAM_FRONT' ]) nusc.render_sample(sample[ 'token' ]) # 전체 센서 + box 시각화 확장 데이터 (Expansion)
확장 내용 사용 예 CAN bus 차량 내부 신호 (위치·속도·가속도, IMU, 조향각, 휠 속도 등) BEVFormer (자차 움직임 정보)Map expansion 벡터 지도 (차선, 횡단보도, 주행 가능 영역 등) MapTR, HDMapNet (온라인 지도 생성) nuScenes-lidarseg / panoptic LiDAR point 단위 semantic / panoptic label LiDAR segmentation
CAN bus는 scene별로 아래 메시지를 제공한다. (can_bus/scene-XXXX_{메시지}.json, 주기는 scene-0103 메시지의 timestamp 간격으로 계산)
메시지 주기 주요 필드 pose50Hz pos, orientation, vel, accel, rotation_ratems_imu100Hz linear_accel, q, rotation_ratesteeranglefeedback100Hz 조향각 zoe_veh_info100Hz 휠 속도, 종·횡 가속도, odometry zoesensors약 1kHz 브레이크, 조향, 스로틀 센서 vehicle_monitor2Hz 차속, yaw rate, 기어, 방향지시등
일부 scene은 CAN bus 데이터가 없다. 이 경우 BEVFormer 변환 코드는 0 벡터를 넣는다.
평가 지표 (3D Object Detection)
nuScenes Detection은 mAP 와 5개 TP(True Positive) 오차 지표 를 결합한 **NDS(nuScenes Detection Score)**로 평가한다.
설정 파일: nuscenes/eval/detection/configs/detection_cvpr_2019.json
평가 전 필터링
클래스별 평가 거리 : ego로부터 car, truck, bus, trailer, construction_vehicle 50m / pedestrian, motorcycle, bicycle 40m / traffic_cone, barrier 30m 밖의 GT와 예측은 제외한다.LiDAR + Radar point가 0개인 GT는 제외 한다. (센서에 거의 보이지 않는 객체)
자전거 거치대(bicycle_rack) 안의 bicycle, motorcycle은 GT와 예측 모두 제외한다.
샘플당 예측은 최대 500개 까지 허용된다.
mAP (mean Average Precision)
3D IoU 대신 **BEV 평면 위 중심점 거리(center distance)**로 GT와 예측을 매칭한다.
작은 물체(보행자, 콘)는 위치가 조금만 틀려도 IoU가 0이 되므로, 거리 기준이 더 안정적이다.
거리 임계값 D = { 0.5 , 1 , 2 , 4 } C
mAP = ∣ C ∣∣ D ∣ 1 c ∈ C ∑ d ∈ D ∑ AP c , d
AP는 Precision-Recall 곡선에서 recall 10% 이상, precision 10% 이상 구간만 사용해 계산한다. (노이즈가 큰 저 recall / 저 precision 구간 제외)
TP 지표 (True Positive Metrics)
거리 임계값 2m 로 매칭된 TP에 대해 계산하고, recall 10% 이상 구간의 평균을 클래스 평균한 값(mTP)이다. 낮을수록 좋다.
지표 의미 단위 / 계산 mATE (Translation)중심 위치 오차 BEV 평면 위 중심점 거리 [m] mASE (Scale)크기 오차 위치·방향을 맞춘 뒤 1 − IoU 3 D mAOE (Orientation)방향 오차 yaw 차이의 최소값 [rad] (barrier는 180° 주기) mAVE (Velocity)속도 오차 2D 속도 벡터 차이의 L2 norm [m/s] mAAE (Attribute)속성 오차 1 − 속성 분류 정확도
traffic_cone은 AOE·AVE·AAE를, barrier는 AVE·AAE를 계산하지 않는다. (방향, 속도, 속성이 의미 없는 클래스)
NDS (nuScenes Detection Score)
NDS = 10 1 [ 5 ⋅ mAP + mTP ∈ TP ∑ ( 1 − min ( 1 , mTP ) ) ]
mAP에 가중치 5, 5개 TP 지표에 각각 가중치 1을 준다. TP 오차는 1에서 잘라서 [ 0 , 1 ]
위치뿐 아니라 크기, 방향, 속도, 속성까지 종합 평가 하므로, 속도 추정이 가능한 시간 정보 모델(BEVFormer 등)이 NDS에서 이점을 가진다.
클래스 AP ATE ASE AOE AVE AAE car 0.478 0.709 0.168 0.194 0.181 0.092 truck 0.389 0.795 0.206 0.280 0.073 0.008 bus 0.576 0.537 0.139 0.097 1.526 0.042 pedestrian 0.446 0.804 0.297 0.736 0.529 0.227 motorcycle 0.286 0.915 0.328 1.608 0.063 0.010 bicycle 0.119 1.097 0.278 0.495 1.492 0.010 traffic_cone 0.354 0.709 0.291 - - - trailer / construction_vehicle / barrier 0.000 1.000 1.000 1.000 1.000 1.000 전체 mAP 0.265 0.857 0.471 0.712 0.733 0.299
NDS = 0.325 mini val 2개 scene에는 trailer, construction_vehicle, barrier GT가 하나도 없어 AP 0, TP 오차 1로 처리된다. 따라서 mini 결과는 전체 val 결과보다 낮게 나오며, 동작 확인 용도로만 봐야 한다.
결과 제출 형식 (results_nusc.json)
{ "meta" : { "use_camera" : true , "use_lidar" : false , "use_radar" : false , "use_map" : false , "use_external" : false }, "results" : { "<sample_token>" : [ { "sample_token" : "<sample_token>" , "translation" : [ x , y , z ], // Global 좌표, 박스 중심 [m] "size" : [ w , l , h ], // [m] "rotation" : [ qw , qx , qy , qz ], // Global 기준 quaternion "velocity" : [ vx , vy ], // Global 기준 [m/s] "detection_name" : "car" , "detection_score" : 0.87 , "attribute_name" : "vehicle.moving" } ] } } 다른 벤치마크 (참고)
Task 주요 지표 Detection mAP, NDS Tracking AMOTA, AMOTP Prediction minADE, minFDE, Miss Rate LiDAR Segmentation mIoU Panoptic PQ, PAT
전체 흐름
nuScenes 원본 (v1.0-*/ JSON + samples/ + can_bus/)
        │  tools/create_data.py  (tools/data_converter/nuscenes_converter.py)
        ▼
nuscenes_infos_temporal_{train,val}.pkl     # sample 1개 = info dict 1개, 시간 순 정렬
        │  CustomNuScenesDataset.get_data_info()   → lidar2img, can_bus 계산
        │  pipeline (이미지 로드, 정규화, 리사이즈, 패딩)
        ▼
img [B, (queue), 6, 3, H, W] + img_metas (lidar2img, can_bus, scene_token, ...)
        ▼
BEVFormer
BEVFormer는 카메라 6장만 입력 으로 사용한다. LiDAR, Radar는 사용하지 않으며, LiDAR는 좌표계 기준 과 GT 필터링(num_lidar_pts)에만 쓰인다.
info pkl 구조
{'infos': [info, ...], 'metadata': {'version': 'v1.0-mini'}} 형태이며, mini 기준 train 323개 / val 81개 info가 있다.
키 형식 내용 tokenstr sample token scene_tokenstr scene 구분 (시간 정보 초기화 기준) prev, nextstr 앞뒤 keyframe token (scene 시작/끝이면 '') frame_idxint scene 내 프레임 번호 (0부터) timestampint LiDAR keyframe 시각 [μs] lidar_pathstr LIDAR_TOP .pcd.bin 경로 lidar2ego_translation / rotationlist LiDAR → Ego ego2global_translation / rotationlist Ego → Global (LiDAR 시각) can_busndarray (18,) 자차 상태 (아래 참고) camsdict 카메라 6개 정보 (아래 참고) sweepslist 이전 LiDAR sweep 최대 10개 (BEVFormer는 미사용) gt_boxesndarray (N, 7) LiDAR 좌표 [x, y, z, w, l, h, yaw'] gt_namesndarray (N,) 10개 Detection 클래스 이름 (그 외 클래스는 원본 이름 유지) gt_velocityndarray (N, 2) LiDAR 좌표 기준 속도 [vx, vy] num_lidar_pts, num_radar_ptsndarray (N,) box 안의 point 개수 valid_flagndarray (N,) num_lidar_pts + num_radar_pts > 0
cams[채널] 구조 (채널 순서: CAM_FRONT, CAM_FRONT_RIGHT, CAM_FRONT_LEFT, CAM_BACK, CAM_BACK_LEFT, CAM_BACK_RIGHT)
키 내용 data_path이미지 경로 sample_data_token, timestamp카메라 sample_data 정보 (촬영 시각) sensor2ego_translation / rotation카메라 → Ego ego2global_translation / rotationEgo → Global (카메라 시각 ) sensor2lidar_rotation (3×3), sensor2lidar_translation (3,)카메라 → LiDAR (시간 차 보상 포함, 위 변환 체인으로 계산)cam_intrinsic (3×3)내부 파라미터 K
데이터셋에서 만드는 입력 (get_data_info)
projects/mmdet3d_plugin/datasets/nuscenes_dataset.py
① lidar2img (카메라 6개 × 4×4)
T l i d a r c am = ( T c am l i d a r ) − 1 , lidar2img = [ K 0 0 1 ] ⋅ T l i d a r c am
BEV 격자의 3D 기준점을 각 카메라 이미지로 투영하는 데 사용된다. (Spatial Cross-Attention)
이미지를 0.5배 리사이즈하는 tiny 모델은 pipeline(RandomScaleImageMultiViewImage)에서 lidar2img에도 같은 scale 행렬을 곱한다.
② can_bus (18차원)
인덱스 내용 출처 0:3 자차 위치 (Global) [m] ego2global_translation으로 덮어씀 3:7 자차 회전 (quaternion) ego2global_rotation으로 덮어씀 7:10 가속도 accel CAN bus pose 메시지 10:13 각속도 rotation_rate CAN bus pose 메시지 13:16 속도 vel CAN bus pose 메시지 16 자차 yaw [rad] (0 ~ 2π) ego pose quaternion에서 계산 17 자차 yaw [deg] (0 ~ 360) ego pose quaternion에서 계산
위치와 yaw는 CAN bus가 아니라 nuScenes ego_pose(LiDAR 맵 매칭 localization) 값 을 사용한다.
시간 정보로 쓸 때 [0:3]과 [17]은 **이전 프레임과의 차이(Δ위치, Δyaw)**로 바뀐다. 이 값으로 이전 BEV feature를 현재 위치에 맞게 회전·이동한다.
scene의 첫 프레임이면 0으로 설정하고 prev_bev_exists = False가 된다.
전체 18차원은 can_bus_mlp를 거쳐 BEV query에 더해진다.
③ GT (학습 시)
valid_flag가 True인 box만 사용한다. (use_valid_flag=True)ObjectNameFilter로 10개 클래스만 남기고, ObjectRangeFilter로 point_cloud_range (x, y ±51.2m) 밖의 box를 제거한다.최종 GT는 LiDARInstance3DBoxes 9차원 [x, y, z_bottom, w, l, h, yaw, vx, vy]이다.
학습 / 추론 시 구성
항목 학습 추론 한 번에 넣는 프레임 현재 + 과거 프레임 (queue) 현재 프레임 1개 과거 프레임 선택 직전 queue_length(tiny: 3)개 중 무작위로 queue_length − 1개 + 현재 - 이전 BEV 과거 프레임으로 no_grad 상태에서 BEV를 만들어 사용 모델 내부 prev_frame_info에 저장된 직전 BEV 사용 scene 경계 queue 안에서 scene이 바뀌면 prev_bev_exists = False scene_token이 바뀌면 이전 BEV 초기화이미지 증강 PhotoMetricDistortionMultiViewImage없음 입력 텐서 (tiny) img: [B, 3, 6, 3, 480, 800]img: [1, 6, 3, 480, 800]데이터 순서 무작위 셔플 가능 (queue가 시간 정보 담당) scene 내 시간 순서, batch 1 필수
이미지 전처리 (tiny): 1600×900 → 0.5배 800×450 → 32 배수 패딩 800×480 , ImageNet mean/std 정규화
참고 사항
커스텀 데이터로 BEVFormer를 사용하려면 위 info pkl과 같은 구조(카메라 6장 경로, cam_intrinsic, sensor2lidar, ego pose, can_bus, scene_token, 시간 순서)를 만들면 된다.
좌표 기준은 **nuScenes LiDAR 좌표계 (x 우측, y 전방, z 위, ego 원점 위 약 1.84m)**에 맞추는 것이 좋다.
_get_can_bus_info()는 sample 시각 직전의 pose 메시지에서 위치·회전을 읽지만, accel / rotation_rate / vel은 코드상 루프를 빠져나온 **직후 메시지(약 20ms 뒤)**에서 읽는다. 영향은 작지만 커스텀 데이터 변환 시 참고한다.create_data.py는 *_mono3d.coco.json (카메라별 2D/3D annotation)도 함께 만들지만, BEVFormer v1은 사용하지 않는다.
참고