멀티 카메라(6대) 영상으로 3D 객체를 검출하는 BEVFormer의 pretrained 모델을 RTX 5080(Blackwell, sm_120) 환경에서 추론하기 위한 환경 구축, 의존성 문제 해결, nuScenes mini 데이터셋 추론 및 시각화
BEVFormer
- 6대 카메라 영상을 BEV(Bird’s-Eye-View) 공간의 feature로 융합하여 3D 객체를 검출하는 Transformer 기반 모델.(ECCV 2022)
- Spatial Cross-Attention: BEV 격자의 3D 기준점을 카메라 캘리브레이션(
lidar2img)으로 각 이미지에 투영하여 feature를 수집한다. - Temporal Self-Attention: 자차 이동 정보(CAN bus)으로 정렬한 이전 프레임 BEV(
prev_bev)를 RNN처럼 누적 → 속도 추정, 가림 대응. - Output: LiDAR 좌표계 기준 3D 박스
[x, y, z, w, l, h, yaw, vx, vy]+ score + 10개 클래스 (NMS 없음). - Git: GitHub - fundamentalvision/BEVFormer
실행 환경
- CPU: Intel(R) Core(TM) Ultra 9 285K (24 threads)
- RAM: 64GB
- OS: Ubuntu-22.04 LTS (kernel 6.8)
- GPU: NVIDIA RTX 5080 16G (Driver 595.99.02)
- CUDA Toolkit: CUDA 12.8, gcc 11.4 → (Ubuntu) Nvidia CUDA Toolkit 12.8 설치
- 날짜: 2026.11.01.
RTX 5080 호환성 문제
문제 요약
- BEVFormer 공식 환경(PyTorch 1.9 + CUDA 11.1)에는 sm_120 커널이 없어 RTX 5080에서 실행할 수 없다.
- error:
no kernel image is available for execution on the device
- error:
- OpenMMLab 1.x 계열(mmcv-full, mmdet3d)은 sm_120용 prebuilt wheel이 없고, PyTorch 2.x에서 컴파일 에러가 발생한다.
| 항목 | BEVFormer 공식 환경 | RTX 5080 적용 환경 |
|---|---|---|
| CUDA | 11.1 | 12.8 (sm_120 지원 시작 버전) |
| PyTorch | 1.9.1+cu111 | 2.7.1+cu128 |
| mmcv-full | 1.4.0 (prebuilt) | 1.7.2 소스 빌드 + 패치 |
| mmdet / mmseg | 2.14.0 / 0.14.1 | 동일 (버전 assert 완화) |
| mmdet3d | 0.17.1 | 동일, 패치 후 소스 빌드 |
| detectron2 | pip git 설치 | 소스 빌드 |
| numpy | - | 1.23.5 고정 |
해결 전략
- PyTorch 2.7.1 + cu128: sm_120을 공식 지원하는 안정 버전.
- mmcv-full 1.7.2: 1.x 마지막 버전으로 PyTorch 2.x를 지원한다.
TORCH_CUDA_ARCH_LIST="12.0"으로 소스 빌드한다. - mmdet3d는 반드시 0.17.1 유지: 1.x는 좌표계가 바뀌어 BEVFormer와 호환되지 않는다.
- numpy 1.23.5 고정: mmdet3d 0.17.1이
np.long,np.int등 1.24에서 제거된 API를 사용한다. - PyTorch 2.x와 맞지 않는 부분만 최소한으로 패치한다.
BEVFormer 환경구축
- 작업 폴더 경로를
WS로 설정하여 설치 과정에서 다룬다.
export WS="./BEVFormer"- pip가 의존성 설치 중 numpy/opencv를 최신으로 올리는 것을 막기 위해
constraints.txt를 만들어 모든 설치에-c옵션으로 사용한다.
numpy==1.23.5
opencv-python==4.9.0.80
setuptools==69.5.1
opencv-python-headless==4.9.0.80
1. Conda 환경 생성 및 PyTorch 설치
conda create -n bevformer python=3.10 -y
conda activate bevformer
pip install torch==2.7.1 torchvision==0.22.1 --index-url https://download.pytorch.org/whl/cu128

# 빌드 도구 + numpy 고정
pip install numpy==1.23.5 ninja "setuptools<70" wheel
# 설치 확인 (sm_120 포함 여부)
python -c "import torch;print(torch.__version__, torch.cuda.get_device_capability(0), torch.cuda.get_arch_list())"
>> 2.7.1+cu128 (12, 0) [..., 'sm_120', 'compute_120']2. 빌드 환경 변수 설정
- 확장 모듈을 빌드하는 nvcc 버전은 PyTorch 빌드 CUDA(12.8)와 맞춘다. (드라이버가 CUDA 13.x를 지원해도 toolkit은 12.8 사용)
export PATH=$CONDA_PREFIX/bin:/usr/local/cuda-12.8/bin:$PATH
export CUDA_HOME=/usr/local/cuda-12.8
export TORCH_CUDA_ARCH_LIST="12.0"     # RTX 5080 = sm_120
export FORCE_CUDA=1
export MAX_JOBS=20
+ 빌드 속도 이슈
Falling back to using the slow distutils backend메시지와 함께 빌드가 수십 배 느려진다.- conda env를 activate 하지 않으면 env의
ninja를 찾지 못함 →conda activate또는$CONDA_PREFIX/bin을 PATH에 추가
3. mmcv-full 1.7.2 소스 빌드
mkdir -p "$WS/third_party" && cd "$WS/third_party"
git clone -b v1.7.2 --depth 1 https://github.com/open-mmlab/mmcv.git mmcv
cd mmcv
MMCV_WITH_OPS=1 pip install --no-build-isolation -v .

# 빌드 후 numpy 2.x / opencv 5.x가 따라 설치되므로 다시 고정
pip install -c "$WS/constraints.txt" numpy==1.23.5 opencv-python==4.9.0.80- ninja 사용 시 빌드 약 5분
+ mmcv 패치 (PyTorch 2.7 DDP 호환)
- 순수 Python 파일이므로 빌드 후 site-packages의
mmcv/parallel/파일을 직접 수정해도 된다.
| 파일 | 에러 | 수정 |
|---|---|---|
mmcv/parallel/distributed.py | no attribute '_use_replicated_tensor_module' | getattr(self, '_use_replicated_tensor_module', False) |
mmcv/parallel/_functions.py | 'int' object has no attribute 'type' | _get_stream(torch.device("cuda", device)) |
4. mmdet 2.14.0 / mmseg 0.14.1 설치
- mmcv 버전 상한(1.4.0) assert를 1.7.2로 완화
- mmdet과 mmseg가 import될 때 실행하는 mmcv 버전 검사에서, 허용 최대 버전을 1.4.0에서 1.7.2로 수정
pip install -c "$WS/constraints.txt" mmdet==2.14.0 mmsegmentation==0.14.1 matplotlib==3.5.2 pycocotools terminaltables prettytable six

SP=$(python -c "import site;print(site.getsitepackages()[0])")
sed -i "s/mmcv_maximum_version = '1.4.0'/mmcv_maximum_version = '1.7.2'/" $SP/mmdet/__init__.py
sed -i "s/MMCV_MAX = '1.4.0'/MMCV_MAX = '1.7.2'/" $SP/mmseg/__init__.py
5. mmdet3d 0.17.1 패치 및 소스 빌드
cd "$WS/third_party"
git clone -b v0.17.1 --depth 1 https://github.com/open-mmlab/mmdetection3d.git mmdetection3d
cd mmdetection3d
# (아래 패치 적용 후)
pip install --no-build-isolation --no-deps -v -e .--no-deps: requirements의numba==0.48.0,numpy<1.20등이 Python 3.10 / torch 2.x와 충돌하므로 의존성은 7번에서 따로 설치한다.
+ mmdet3d 패치
| 위치 | 에러 | 수정 |
|---|---|---|
mmdet3d/ops/*/src/*.cpp (6개 op) | THC/THC.h: No such file | #include <THC/THC.h>, extern THCState *state; 삭제 |
ball_query, group_points, interpolate | 'getCurrentCUDAStream' is not a member of 'at::cuda' | #include <ATen/cuda/CUDAContext.h> 추가 |
setup.py (spconv) | PyTorch 2.x 헤더 컴파일 에러 | -std=c++14 → -std=c++17 |
mmdet3d/__init__.py | mmcv 버전 assert 실패 | mmcv_maximum_version = '1.7.2' |
mmdet3d/ops/spconv/conv.py | SparseConv2d is already registered | @CONV_LAYERS.register_module(force=True) |
datasets/pipelines/data_augment_utils.py | No module named 'numba.errors' | from numba.core.errors import ... |
6. detectron2 소스 빌드
- BEVFormer 플러그인이 V2용
dd3d를 함께 import하므로 v1 모델만 추론해도 detectron2가 필요하다.
cd "$WS/third_party"
git clone https://github.com/facebookresearch/detectron2.git detectron2
cd detectron2
pip install -c "$WS/constraints.txt" --no-build-isolation -v -e .
7. 나머지 의존성 설치
pip install -c "$WS/constraints.txt" einops seaborn timm==0.6.13 numba==0.56.4 pandas==1.5.3 \
    scikit-image==0.19.3 nuscenes-devkit lyft_dataset_sdk plyfile trimesh "networkx>=2.5" scipy ipython==8.12

# nuscenes-devkit이 opencv-python-headless를 최신으로 올리므로 버전 맞춤
pip install -c "$WS/constraints.txt" --force-reinstall --no-deps opencv-python==4.9.0.80 opencv-python-headless==4.9.0.80ipython: BEVFormer 평가 코드가from IPython import embed를 import한다.pip check에 mmdet3d 원래 버전 핀과 맞지 않는다는 경고가 남지만 동작에는 문제 없다.
8. BEVFormer 다운로드 및 패치
cd "$WS"
git clone https://github.com/fundamentalvision/BEVFormer.git
+ dataset pickle 이슈
- error:
TypeError: cannot pickle 'dict_keys' object(DataLoader worker 시작 시) - 원인:
mmcv.runner.init_dist()가 multiprocessing을spawn으로 설정하는데, nuscenes-devkit의class_names가dict_keys라 pickle할 수 없다. projects/mmdet3d_plugin/datasets/nuscenes_dataset.py(및 V2용nuscenes_dataset_v2.py)의__init__에 추가
self.eval_detection_configs.class_names = list(
    self.eval_detection_configs.class_names)
최종 패키지 버전
| 패키지 | 버전 | 설치 방식 |
|---|---|---|
| Python | 3.10 | conda |
| torch / torchvision | 2.7.1+cu128 / 0.22.1+cu128 | pip |
| mmcv-full | 1.7.2 | 소스 빌드 + 패치 |
| mmdet / mmsegmentation | 2.14.0 / 0.14.1 | pip + assert 완화 |
| mmdet3d | 0.17.1 | 소스 빌드 + 패치 |
| detectron2 | 0.6 (main) | 소스 빌드 |
| numpy | 1.23.5 | 고정 |
| numba / llvmlite | 0.56.4 / 0.39.1 | |
| opencv-python(-headless) | 4.9.0.80 | 고정 |
| timm / nuscenes-devkit | 0.6.13 / 1.2.0 |
샘플 데이터셋 구성 (nuScenes mini)
데이터셋 참고: (Dataset) nuScenes Dataset
다운로드
- nuScenes는 CC BY-NC-SA 4.0 (비상업) 라이선스
| 파일 | 크기 | 출처 |
|---|---|---|
bevformer_tiny_epoch_24.pth | 400MB | GitHub Release |
v1.0-mini.tgz | 4.2GB | nuScenes |
can_bus.zip | 780MB | nuScenes CAN bus |
cd "$WS/BEVFormer"
mkdir -p ckpts data/nuscenes downloads
wget -c https://github.com/zhiqi-li/storage/releases/download/v1.0/bevformer_tiny_epoch_24.pth -O ckpts/bevformer_tiny_epoch_24.pth
wget -c -P downloads https://d36yt3mvayqw5m.cloudfront.net/public/v1.0/can_bus.zip
wget -c -P downloads https://www.nuscenes.org/data/v1.0-mini.tgz
tar -xzf downloads/v1.0-mini.tgz -C data/nuscenes
unzip -q downloads/can_bus.zip -d data
info pkl 생성
- 카메라 경로, 캘리브레이션(
lidar2img), ego pose, CAN bus, 시간 순서 정보를 담은 BEVFormer 입력용 pkl 생성
PYTHONPATH=. python tools/create_data.py nuscenes --root-path ./data/nuscenes \
    --out-dir ./data/nuscenes --extra-tag nuscenes --version v1.0-mini --canbus ./data
>> data/nuscenes/nuscenes_infos_temporal_{train,val}.pkl   # val = 81 samples (2 scenes)
폴더 구조
BEVFormer/
├── ckpts/bevformer_tiny_epoch_24.pth
├── data/
│   ├── can_bus/
│   └── nuscenes/
│       ├── maps/  samples/  sweeps/  v1.0-mini/
│       └── nuscenes_infos_temporal_{train,val}.pkl
├── test/          # 추론 결과 (results_nusc.json)
└── vis_results/   # 시각화 결과
BEVFormer 추론 테스트
Inference & Evaluation
cd "$WS/BEVFormer"
conda activate bevformer
PYTHONPATH=. torchrun --nproc_per_node=1 --master_port=29503 \
    tools/test.py projects/configs/bevformer/bevformer_tiny.py ckpts/bevformer_tiny_epoch_24.pth \
--launcher pytorch --eval bbox- 결과:
test/bevformer_tiny/<timestamp>/pts_bbox/(results_nusc.json,metrics_summary.json)
+ 실행 이슈
tools/dist_test.sh사용 불가: torch 2.x의torch.distributed.launch는--local-rank를 넘기지만test.py는--local_rank만 받음 →torchrun사용- GPU 1장이어도
--launcher none불가:test.py의 non-distributed 분기가assert False로 막혀 있음 →torchrun --nproc_per_node=1 --cfg-options data.test.version=...사용 금지: 버전은 pkl의 metadata에서 자동으로 읽는다.
추론 결과 (BEVFormer-tiny, nuScenes mini val 81 samples)
mAP: 0.2647   NDS: 0.3252
mATE: 0.8565  mASE: 0.4707  mAOE: 0.7122  mAVE: 0.7330  mAAE: 0.2986
| 항목 | 결과 |
|---|---|
| 순수 추론 속도 (fp32, bs=1) | 20.3 FPS (49.3 ms) |
| 추론 최대 GPU 메모리 | 625 MiB |
| 공식 full val (참고) | NDS 35.4 / mAP 25.2 |
- mini val은 2개 scene뿐이라 공식 수치와 직접 비교는 어렵지만, 같은 범위의 값이므로 sm_120 커널이 정상 동작함을 확인했다.
결과 시각화
tools/test.py --show는 non-distributed 분기가 막혀 있어 사용할 수 없다.- BEVFormer 공식 시각화 스크립트
tools/analysis_tools/visual.py를 사용하되,__main__에v1.0-trainval과 결과 경로가 하드코딩되어 있으므로 모듈로 import하여 직접 호출한다.
cd "$WS/BEVFormer"
MODEL=bevformer_tiny
R=$(ls -d test/$MODEL/*/pts_bbox | tail -1)/results_nusc.json
mkdir -p vis_results/$MODEL
MPLBACKEND=Agg PYTHONPATH=. python -W ignore -c "
import sys, mmcv, multiprocessing as mp, contextlib, io; sys.path.insert(0,'tools/analysis_tools')
import visual
from nuscenes.nuscenes import NuScenes
visual.nusc = nusc = NuScenes(version='v1.0-mini', dataroot='./data/nuscenes', verbose=False)
res = mmcv.load('$R'); toks = list(res['results'].keys())
out = 'vis_results/$MODEL'
def job(a):
    i, t = a
    scene = nusc.get('scene', nusc.get('sample', t)['scene_token'])['name']
    with contextlib.redirect_stdout(io.StringIO()):
        visual.render_sample_data(t, pred_data=res, out_path=f'{out}/{i:03d}_{scene}_{t}', verbose=False)
with mp.get_context('fork').Pool(8) as p: p.map(job, list(enumerate(toks)))
"- 출력:
{순번}_{scene}_{token}_{bev|camera}.png(81 samples × 2 = 162장, 8 프로세스로 약 1분)
| 파일 | 내용 |
|---|---|
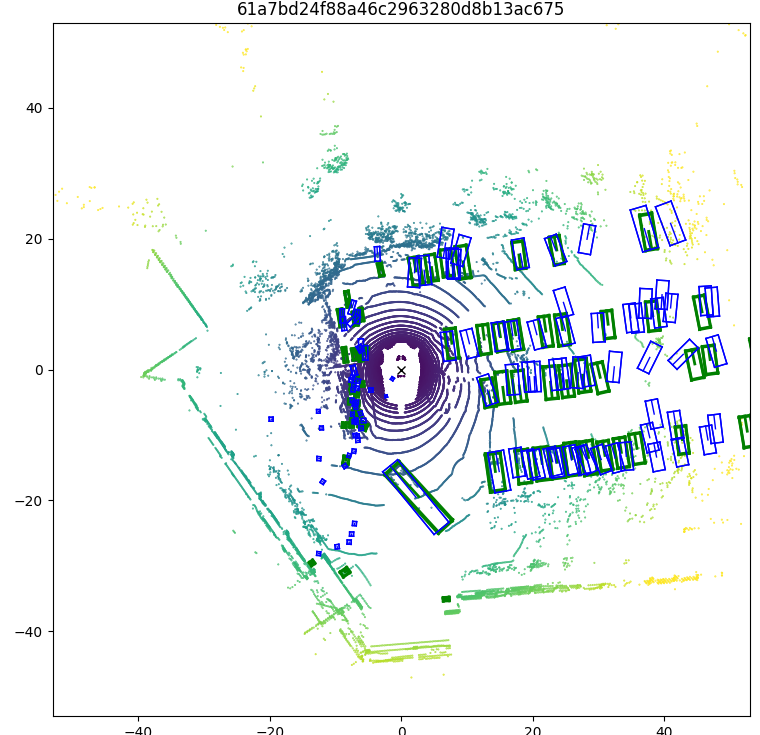
*_bev.png | LiDAR 포인트 위에 3D 박스를 그린 Top-View (±50m). 초록 = GT, 파랑 = 예측 (score ≥ 0.15) |
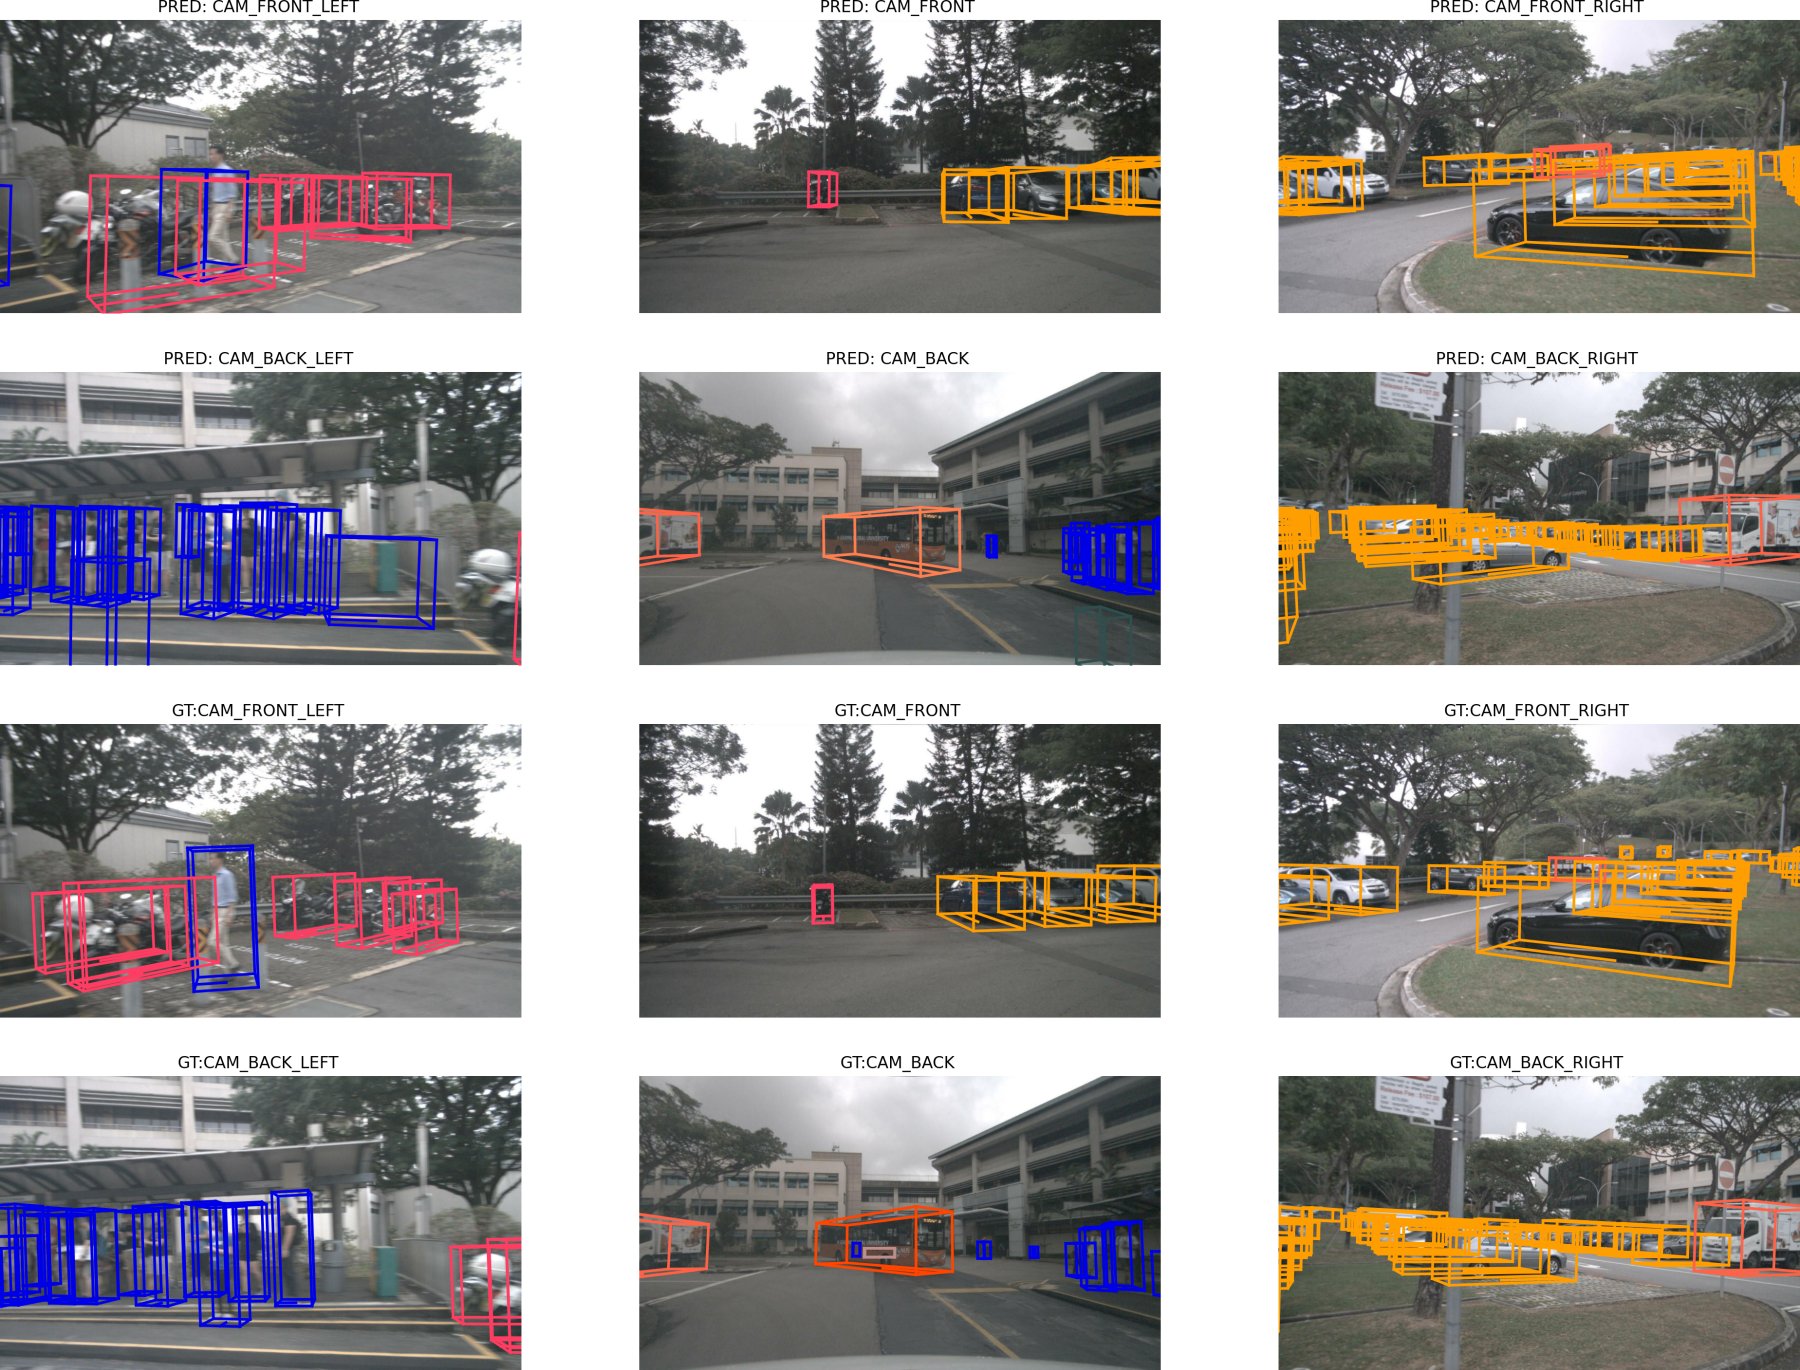
*_camera.png | 6개 카메라 4×3 격자. 위 2줄 = 예측, 아래 2줄 = GT (score > 0.2) |
- BEV 화면의 방사형 점들은 시각화 배경으로 그린 **LiDAR 포인트(GT 센서 데이터)**이며, 모델의 출력은 박스뿐이다.
시각화 결과
scene-0916 (#053) — 주차장, 버스·보행자·이륜차
- Camera: 위 2줄 = 예측, 아래 2줄 = GT (주황 = 차량, 진한 주황 = 버스, 분홍빨강 = 이륜차, 파랑 = 보행자)
- BEV (초록 = GT, 파랑 = 예측): 주차 차량 열과 후방의 버스 위치·방향이 GT와 잘 맞는다.
scene-0103 (#032) — 도심 교차로, 노상 주차 차량
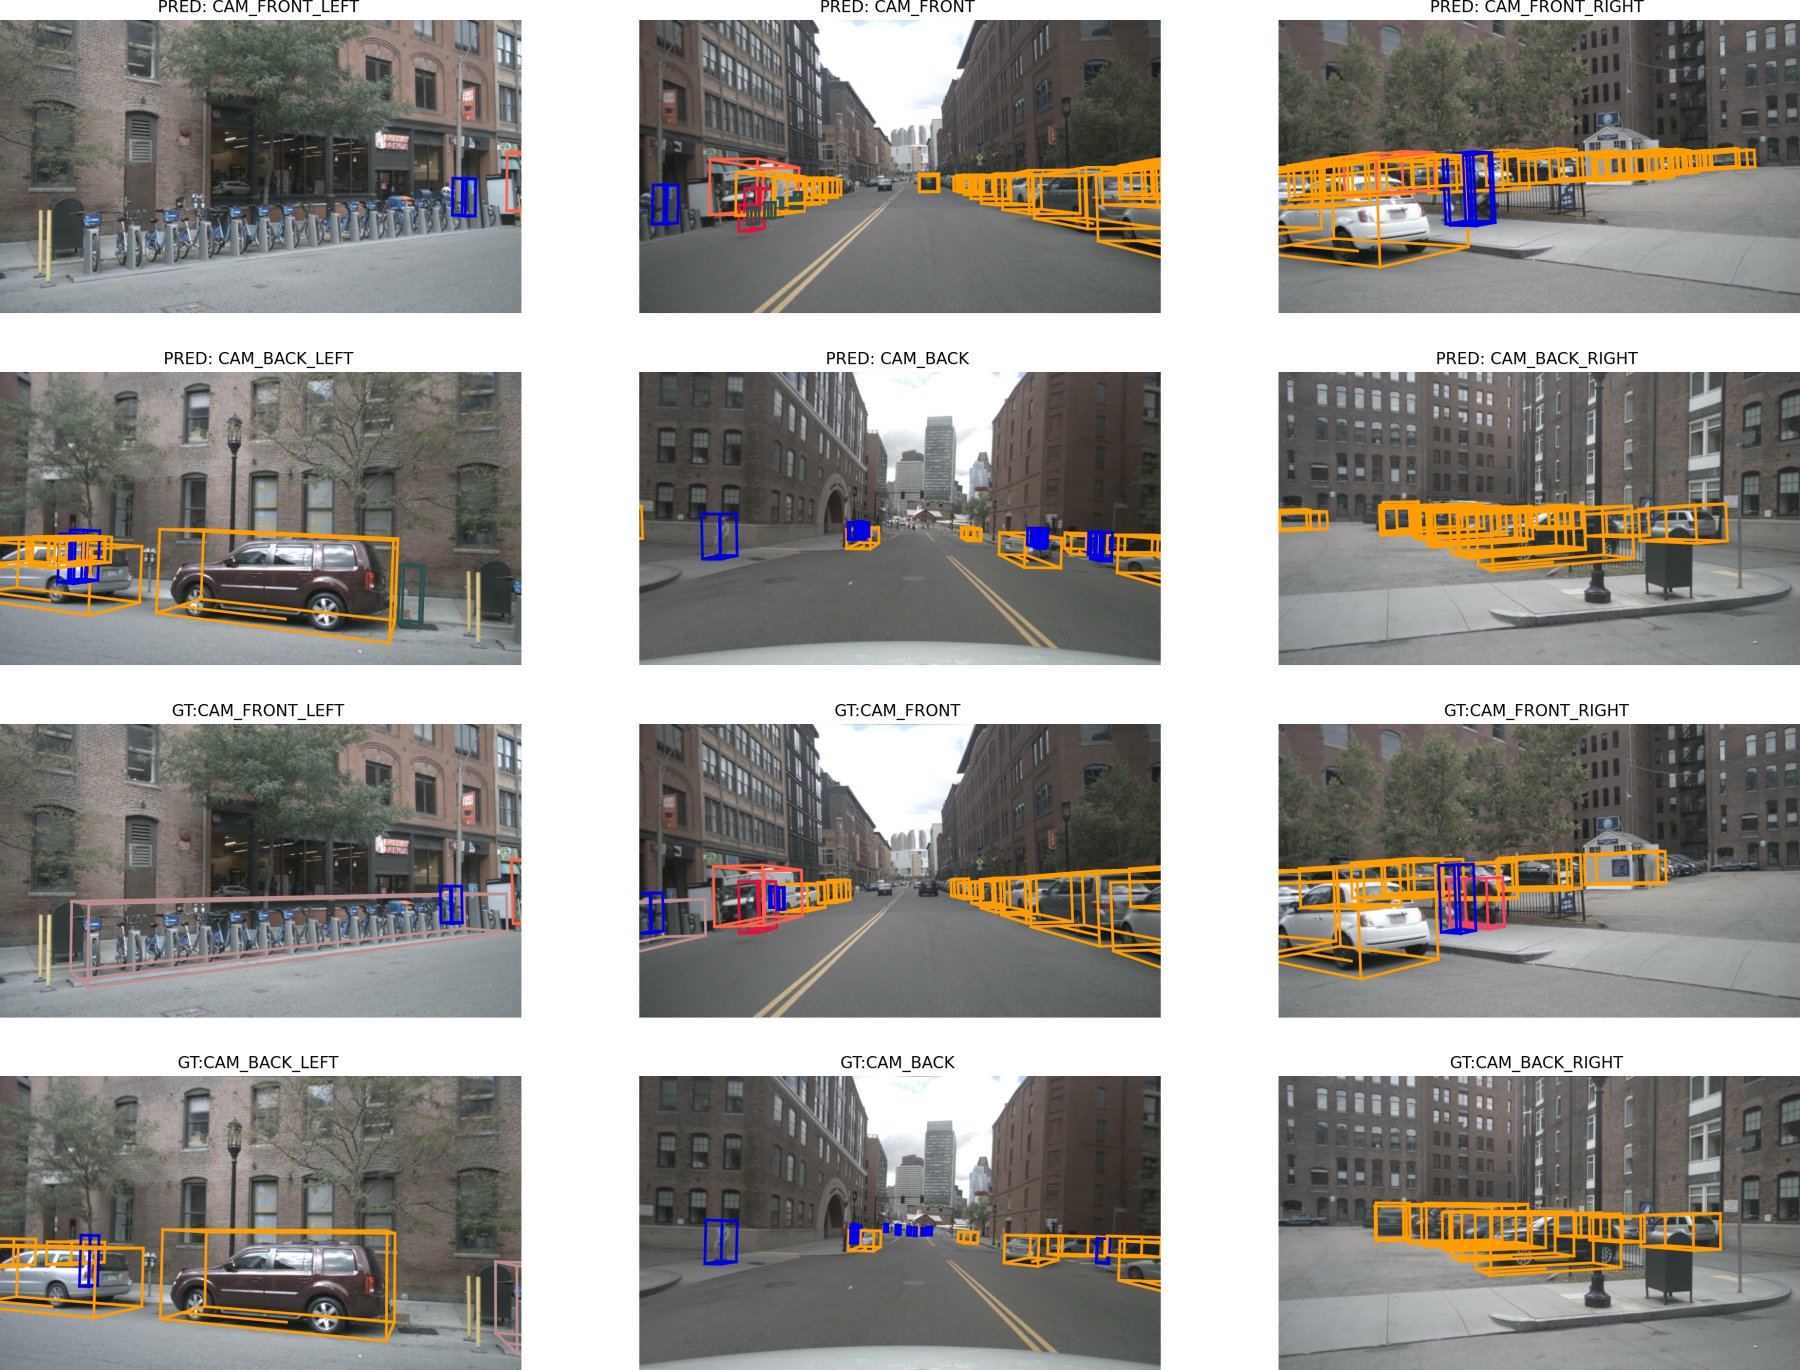
-
도로 양옆 주차 차량이 40m 이상 거리까지 GT와 일치. 오른쪽 원거리(30~50m)에서는 GT 없는 예측 박스가 일부 나타난다.
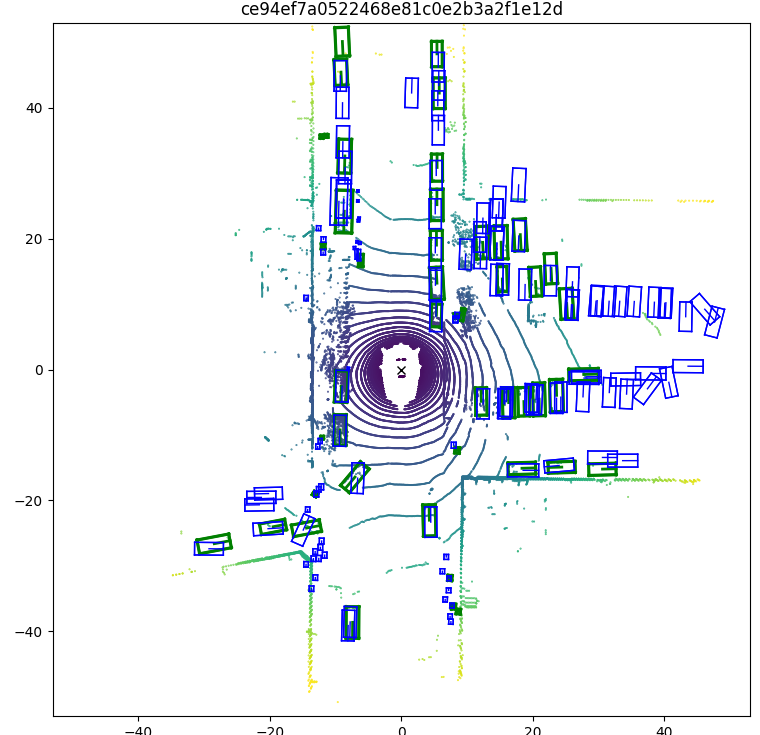
-
차량과 근처 보행자는 GT와 위치·크기가 잘 맞는다.
-
멀리 있는 보행자 무리(15
40m)에서 score 0.150.3 부근의 false positive 다수 → 시각화 임계값을 0.3~0.4로 올리면 감소 -
tiny 모델(R50, BEV 50×50, 입력 0.5배)의 한계와 일치한다 (pedestrian AP 0.446).
추가 참고 사항
추론 시 주의점
- BEVFormer는 이전 프레임 BEV를 모델 내부에 저장해 다음 프레임에 사용하므로, scene 내 시간 순서대로 batch 1로 추론해야 한다 (샘플 순서를 섞으면 시간 정보가 무의미해진다).
- GPU 여러 장으로 나누어 평가하면 시퀀스가 잘려 성능이 약간 낮아진다.
- 커스텀 데이터로 추론하려면 **6대 카메라 이미지(nuScenes 순서) + 카메라별 내부·외부 파라미터(
lidar2img) + 프레임별 ego pose(CAN bus)**가 반드시 필요하다.- 카메라 파라미터는 학습이 아니라 매 추론의 입력으로 사용된다 (BEV 기준점 → 이미지 투영).
- 기준 좌표계(x=오른쪽, y=전방, z=위, ego 원점 기준 1.84m), 카메라 배치, 화면 속 물체 크기, 프레임 간격(2Hz)이 nuScenes와 비슷할수록 유리하다.
GPU 메모리
- 학습 시 GPU 하나에 할당되는 메모리 크기는 tiny 6.5GB / small 10.5GB / base 28.5GB / V2 24~40GB → RTX 5080(16GB)에서는 tiny, small만 원래 설정으로 학습 가능할 것으로 예상됨.